MCP 和 LSP
MCP 与 LSP:为什么需要统一协议?
MCP(Model Context Protocol)与 LSP(Language Server Protocol)解决的是不同领域的问题,但两者背后的设计思想高度一致:
通过引入统一的协议层,将原本需要逐对适配的多对多关系,转变为客户端和服务端分别遵循标准协议的连接关系。
在理想情况下,集成工作量可以从 M×N 组专用适配,降低为 M+N 份协议实现。
但这里有两个值得深入思考的问题:
- 为什么没有统一协议时,双方需要重复适配?这些工作究竟由谁承担?
- 统一协议不仅方便编辑器、AI 应用等客户端,对编程语言工具和外部服务的开发者又有什么价值?
一、没有统一协议时,问题是什么?
假设存在 M 种编辑器和 N 种编程语言。每个编辑器都希望支持代码补全、跳转到定义、查找引用等语言智能功能。在没有 LSP 的情况下,不同编辑器往往通过各自的插件 API 提供这些能力。
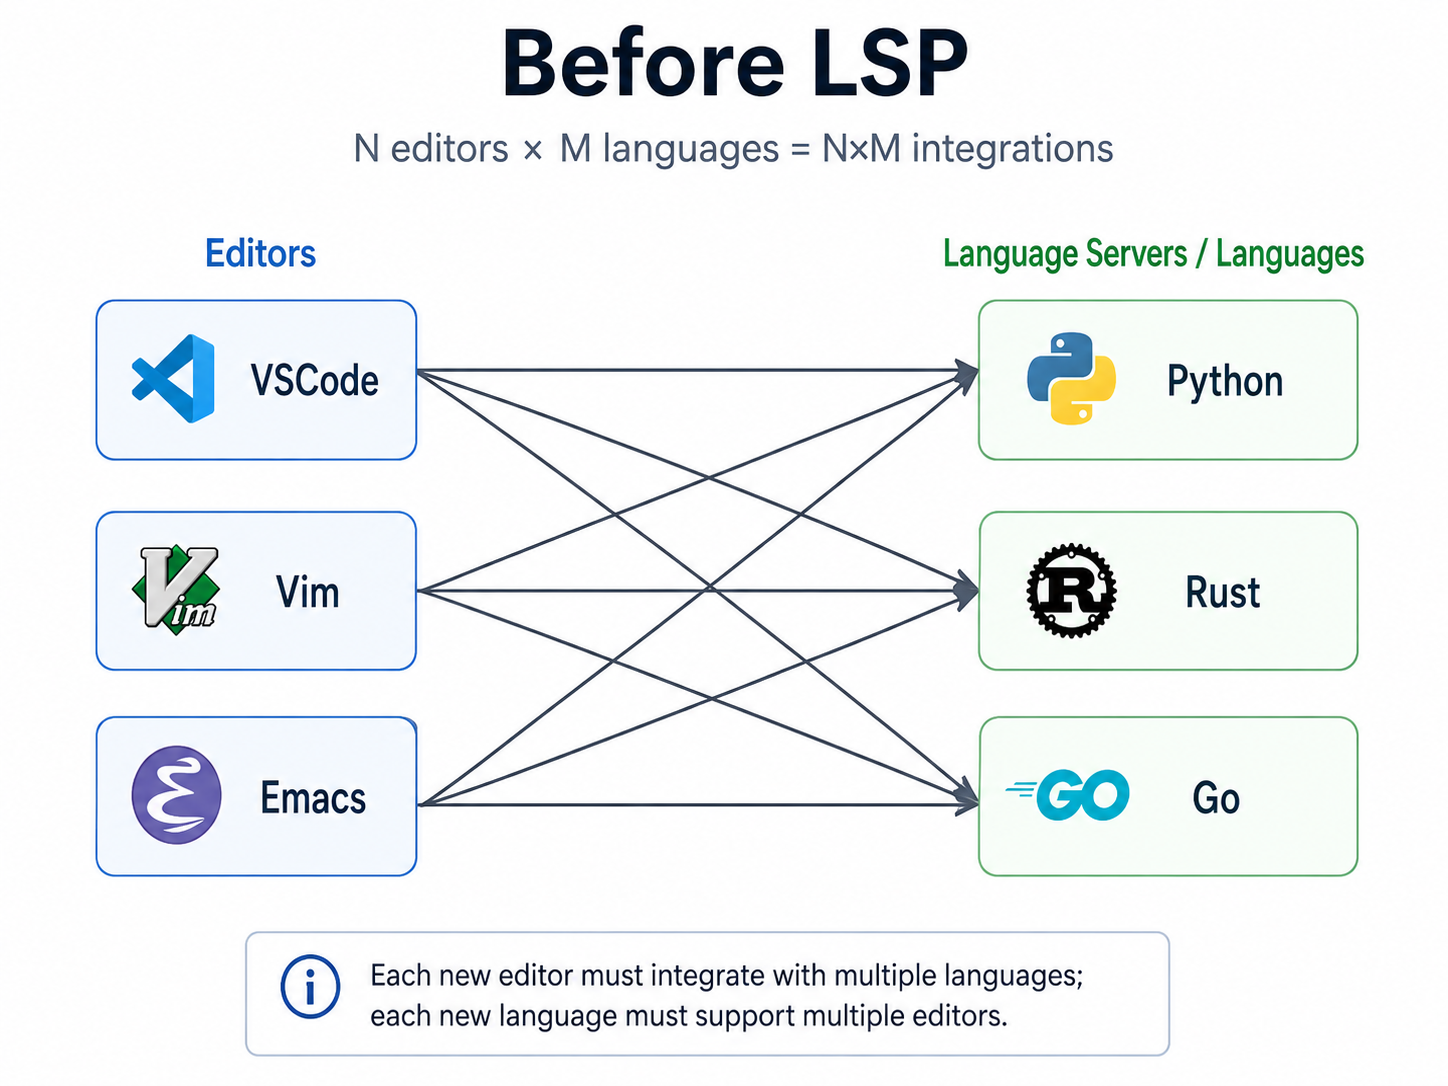
例如,开发者已经实现了某种编程语言的解析器、类型检查器和符号分析器,希望让 VS Code、IntelliJ IDEA、Eclipse 等编辑器都支持这门语言。虽然底层语言分析能力可以复用,但不同编辑器的扩展接口并不一致,仍然需要编写相应的集成代码。同样,假设编辑器开发者希望支持一种新语言,也需要解决如何调用其语言分析工具、如何获取代码结构、如何把分析结果转换成编辑器能够理解的数据等问题。
MCP 面临类似的情况。
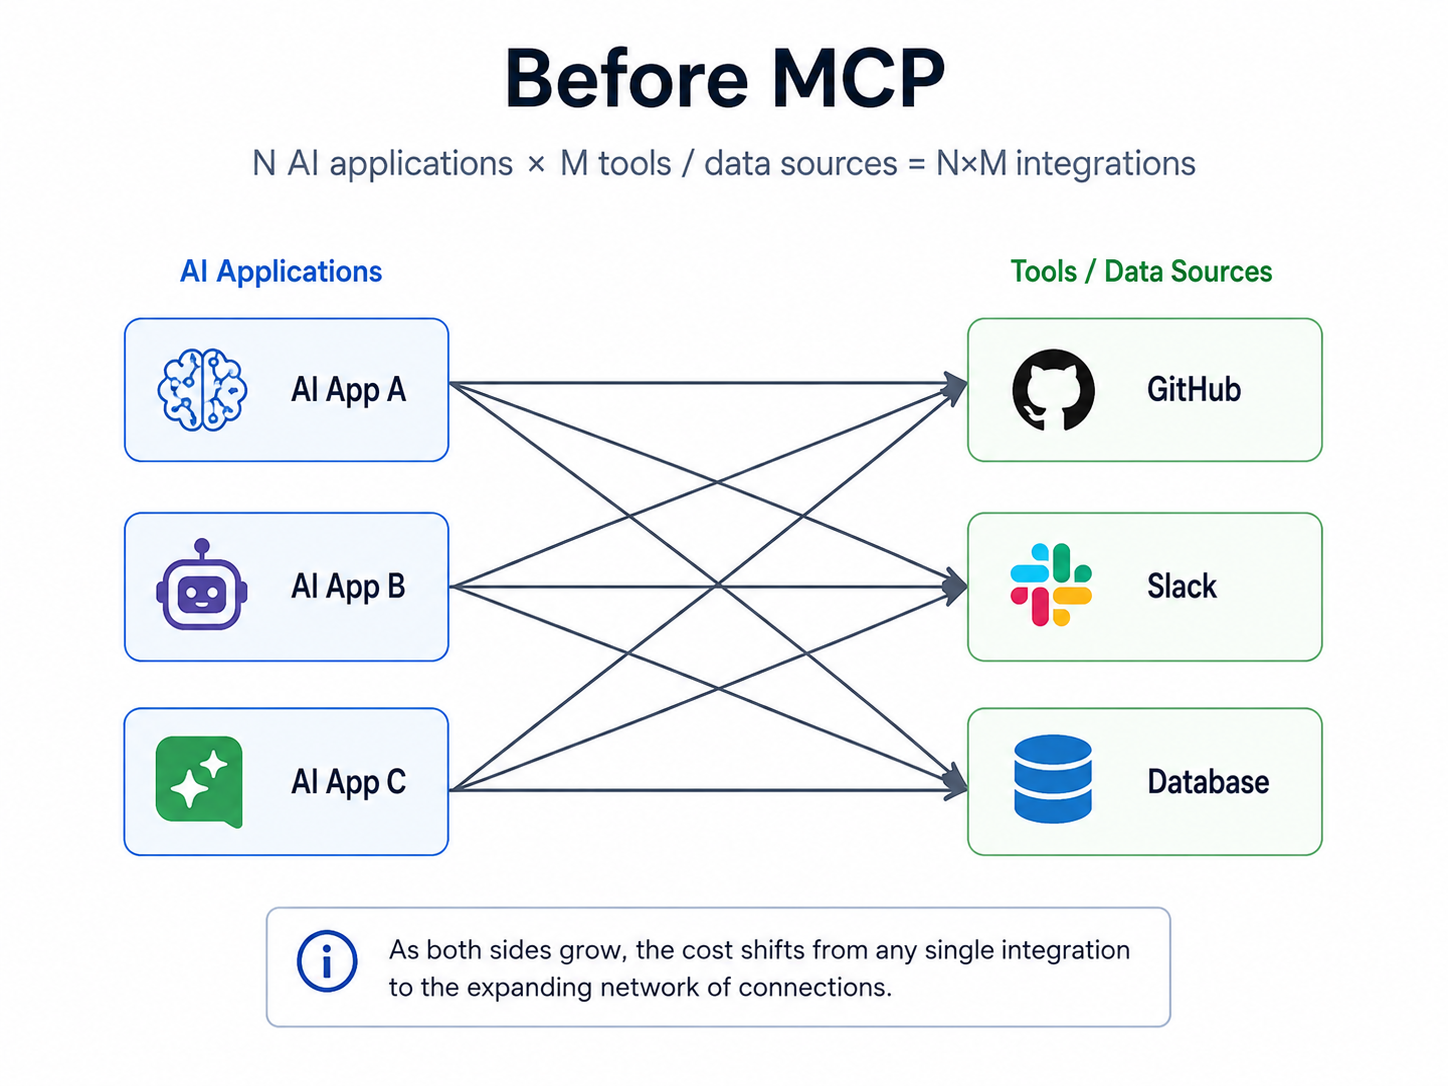
假设 Claude Code、Cursor、Codex 等 AI 应用都希望接入 GitHub、数据库、代码知识图谱等外部能力。外部系统可能已经提供 HTTP API,但这并不意味着 AI 应用能够直接使用这些能力。AI 应用还需要知道有哪些工具、工具接受什么参数、如何发起调用,以及如何处理调用结果。如果各 AI 应用都有不同的工具扩展机制,就需要为它们分别开发集成代码。
这里重复的并不是编程语言解析或外部系统的业务逻辑,而是客户端与服务端之间的适配工作。
1.1 集成工作究竟由谁承担?
一个容易忽略的问题是:集成任务并不一定由客户端开发者承担。
以 LSP 为例,有两种常见方式:
- 编辑器开发者主动支持某种编程语言,编写语言适配代码。
- 语言工具开发者主动支持某种编辑器,按照该编辑器的插件接口开发语言插件。
MCP 同样如此:
- AI 应用开发者主动接入外部工具,编写工具调用适配代码。
- 外部工具开发者主动支持某个 AI 应用,提供专门的插件或集成方案。
所以,缺少统一协议时,问题不在于集成工作必须由某一方承担,而在于无论由谁承担,这些集成都可能与特定的客户端和服务端组合绑定,难以在其他组合中直接复用。
例如,某种编程语言已经有 VS Code 插件,并不意味着它能够直接用于 Eclipse。
同样,某个数据库已经实现了面向 Claude Code 的专用集成,也不意味着这套集成能够直接用于另一款 AI 应用。
当双方数量持续增长时,昂贵的不只是单次集成,而是不断增加的专用连接关系及其长期维护成本。
二、统一协议如何解决这个问题?
LSP 和 MCP 都采用了类似的解决方式:在客户端与服务端之间建立一套双方共同遵循的协议。
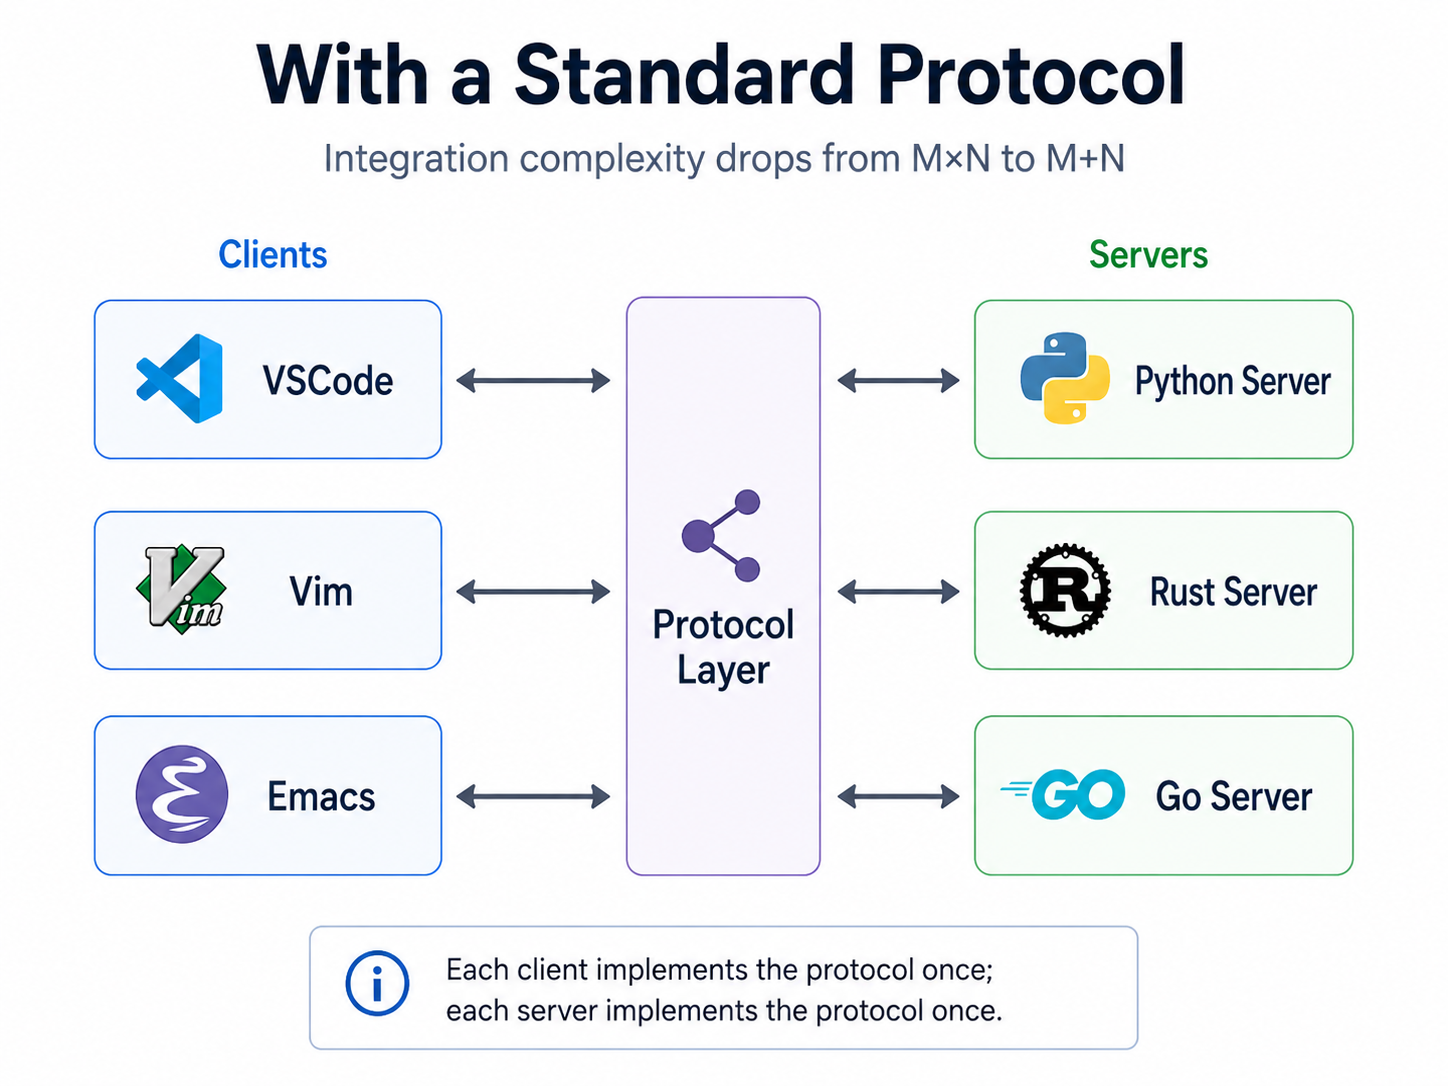
以 LSP 为例,编辑器实现 LSP Client,语言工具实现 Language Server。双方通过标准协议交换代码补全、定义跳转、错误诊断等请求和结果。这里的 Language Server 不一定由编译器直接提供,它也可以由独立的语言分析工具实现。当一种新的编程语言提供了 Language Server,支持 LSP 的编辑器就可以复用它的语言分析能力,而不必重新实现整套语言智能功能。反过来,一款新的编辑器只要实现通用 LSP Client,就可以接入不同语言已有的 Language Server。
MCP 也是如此。AI 应用通过 MCP Client 访问外部能力,外部工具则通过 MCP Server 暴露工具、资源和其他上下文能力。以工具调用为例,MCP 定义了统一的工具发现和调用方式:
tools/list:客户端获取服务端提供的工具及其名称、描述、参数 Schema。tools/call:客户端按照统一规范传递工具名称和参数,并接收调用结果。
因此,只要 AI 应用支持 MCP,它就可以通过相同的交互机制访问不同的 MCP Server,而不必为每种工具重新设计通信接口。
2.1 用 CodeGraph 理解 MCP 的复用机制
以 CodeGraph 为例。CodeGraph 可以解析代码仓库,构建本地代码知识图谱,记录函数、类、文件以及调用、继承、依赖等关系,支持查询相关源码、调用链和代码变更的影响范围。
假设我们希望 Claude Code、Cursor、Codex 都能使用这些代码分析能力。没有统一协议时,可以分别为每个 AI 应用开发插件,让它们调用 CodeGraph 的查询 API。虽然代码知识图谱和查询 API 只需要实现一次,但面向不同 AI 应用的工具注册、参数描述和调用适配仍可能需要分别实现。
使用 MCP 后,CodeGraph 通过一个 MCP Server 暴露 codegraph_explore 工具。不同 AI 应用通过已有的 MCP Client 接入,使用同一套工具接口。
实际交互过程可以简化为:
- AI 应用通过 MCP Client 获取 CodeGraph 提供的工具定义。
- AI 应用将工具定义交给大模型,大模型根据用户问题决定是否调用
codegraph_explore。 - AI 应用通过 MCP Client 向 CodeGraph MCP Server 发起工具调用。
- MCP Server 查询本地代码知识图谱,获取相关源码、调用链和影响范围。
- 查询结果沿 MCP 返回给 AI 应用,再由大模型结合这些信息生成回答。
需要注意,大模型本身通常不直接连接 MCP Server,而是由 AI 应用负责模型与工具之间的调用编排。
在这个过程中,CodeGraph 的知识图谱负责提供代码分析能力,MCP Server 负责将这些能力暴露为标准化接口,而 MCP Client 负责发现和调用这些能力。三者职责不同,这也体现出 MCP 的复用价值:
CodeGraph 不必针对每个 AI 应用分别实现工具插件;AI 应用也不必针对 CodeGraph 开发专用的工具通信机制。 实际接入仍可能需要安装、配置、权限授权和少量客户端集成,但不必重复开发整套专用适配逻辑。
2.2 为什么统一协议能够同时利好双方?
这也是 LSP 和 MCP 最容易被忽略的价值。
站在客户端开发者的角度:
- 编辑器开发者希望实现一次 LSP Client,就能复用不同编程语言的 Language Server。
- AI 应用开发者希望实现一次 MCP Client,就能接入不同外部工具的 MCP Server。
客户端获得的是集成成本降低和可接入能力的扩展。
站在服务端开发者的角度:
- 语言工具开发者希望实现一次 Language Server,就能被不同编辑器使用。
- 外部工具开发者希望提供一个 MCP Server,就能被不同 AI 应用接入。
服务端获得的是集成成本降低和工具分发范围扩大。
例如,一个新语言工具不需要等待每款编辑器官方适配,也不需要对所有编辑器自行开发插件,只需要实现 LSP,就能被多个支持 LSP 的编辑器使用。
同样,一个新的代码分析工具也不需要等待每家 AI 应用厂商主动支持(甚至有可能拒绝支持),也不需要自己开发多个插件兼容所有 AI 引用,只需要通过实现 MCP Server 进入已有的 AI 工具生态。
当然,这种收益取决于两侧对协议的支持程度。如果工具提供方原本只需要维护一个 HTTP API,并不打算承担 AI 集成工作,那么开发 MCP Server 本身就是额外投入。
因此,统一协议并不是简单地把适配工作从客户端转移给服务端,而是让两侧分别面向同一个标准实现接口,从而减少针对特定产品组合的重复开发。
2.3 M×N 为什么能够变成 M+N?
假设有 3 个 AI 应用和 5 个外部工具。
如果所有组合都需要相互连接,并且每组连接都采用独立的私有适配方式,那么可能需要维护:
3 × 5 = 15 组集成。
采用 MCP 后,理想情况下,3 个 AI 应用分别实现通用 MCP Client,5 个工具分别实现 MCP Server。
主要的协议适配工作就变成:
3 + 5 = 8 份实现。
而且,当两侧都已经支持 MCP 时,新增一款兼容的 AI 应用或者外部工具,往往只需要完成连接配置,不需要重新开发专用的协议适配代码。
不过,M×N → M+N 是对集成结构的抽象,不是所有系统都必然满足的成本公式。
首先,即使没有 MCP,我们也可以通过 SDK、统一 API 网关或内部 Adapter 层消除重复开发,并不一定真的需要 M×N 份实现。
其次,MCP 不会消除所有工作。MCP Server 仍然需要对接真实的业务 API,客户端仍然需要负责工具调用编排,还可能存在认证授权、版本兼容、权限控制等额外成本。
因此,MCP 最核心的贡献不是首次提出统一适配层,而是将这套交互规范变成开放标准,使不同团队、不同厂商的实现能够跨产品复用。
三、什么时候值得引入统一协议?
是否需要引入类似 LSP、MCP 的协议层,不能只看系统有多少接口,更应该看连接关系是否复杂,以及是否需要跨产品复用。
3.1 存在明显的多对多集成需求
当消费者和提供者都存在多种实现,而且需要大量交叉集成时,统一协议的价值会逐渐增大。
例如,一个编辑器希望支持几十种语言,一个 AI 应用希望接入大量第三方工具,或者一个工具提供方希望自己的能力能在不同客户端中使用。
需要强调的是,系统规模本身不是决定性因素,跨产品复用的需求才是关键。
3.2 两侧由不同团队独立演进
如果客户端和服务端分别由不同团队、组织或公司维护,双方难以协调统一的发布周期。
稳定的协议可以成为共同依赖的契约。
客户端不必关心服务端内部如何实现,服务端也不必关心客户端具体如何组织代码和界面。
只要协议保持兼容,双方就可以相对独立地演进。
3.3 希望支持开放生态
这是 LSP 和 MCP 相比内部 Adapter 或 SDK 更突出的价值。
如果所有系统都由同一个团队维护,那么自定义接口也可以很好地解决复用问题。
但开放生态中,不同开发者不可能事先协调所有集成方式。
统一协议提供了一种公共约定,使第三方只需面向标准接口开发,就有机会与已有生态中的产品互操作。
这对客户端和服务端都有正向作用:支持协议的客户端越多,服务端越有动力实现协议;支持协议的服务端越多,客户端实现协议的价值也越高。
这种双向促进,是协议能够形成生态的重要原因。
反过来,如果系统只有一个客户端和一个服务端,连接关系长期固定,双方又由同一团队维护,那么直接调用 HTTP API、使用 SDK 或开发轻量 Adapter 往往更简单。
因为协议并不是免费的。它同样需要承担规范维护、版本兼容、能力协商、通信和安全管理等成本。
因此,不能为了架构完整而引入协议,而应该根据实际的互操作需求决定。
四、从 LSP 和 MCP 看更一般的架构思想
从这个角度出发,会发现类似的设计在软件和硬件领域已经存在很久。
例如:
- LLVM IR:通过统一的中间表示,连接多种编程语言前端和不同目标架构的后端。
- ODBC / JDBC:通过标准数据库访问接口,降低应用程序与不同数据库之间的适配成本。
- USB:标准化主机与外围设备之间的连接和通信方式。
- LSP:标准化编辑器与语言分析工具之间的交互。
- MCP:标准化 AI 应用与外部工具、数据源及上下文能力之间的交互。
它们的具体实现并不相同。LLVM IR 是编译器中间表示,ODBC/JDBC 是数据库访问接口体系,USB 是硬件及通信标准,LSP 和 MCP 则是面向特定软件生态的通信协议。
但它们都体现了一种相似的架构思想:
当系统两侧存在大量可替换的实现时,通过稳定的中间契约隔离双方差异,使各方无需理解所有对端的具体实现。
这种方式不仅减少重复开发,还改变了系统扩展的方式。
没有统一标准时,新增一个系统可能意味着需要协调多个已有系统进行适配。
有了被广泛支持的统一标准后,新增系统首先只需要考虑是否符合共同协议,而不必逐一理解每个已有系统的内部实现。
总结
LSP 和 MCP 表面上分别解决编程语言支持和 AI 工具集成的问题,但其核心都是降低多对多系统之间的互操作成本。
理解它们时,需要区分两个问题:
第一,集成工作由谁承担?
可能由客户端开发者承担,也可能由服务端开发者承担,还可能由第三方完成。这决定了适配成本如何在不同参与者之间分配。
第二,集成工作能否跨产品复用?
这才是统一协议着重解决的问题。
LSP 让编辑器和语言工具分别实现统一接口,MCP 让 AI 应用和外部能力提供方分别实现统一接口。客户端能够复用更多外部能力,服务端也能够让自己的能力被更多客户端使用。
因此,统一协议的价值并不是简单地增加一层抽象,更不是把工作从一方转移给另一方,而是让双方从“面向具体产品开发集成”转变为“面向共同标准实现能力”。
从更一般的架构角度看:
当系统之间的连接成本逐渐超过各个系统自身的实现成本时,建立稳定、开放、可复用的中间契约,往往比持续增加专用适配器更有长期价值。
评论